
邊緣運算(Edge Computing)是一種分散式運算架構,將資料的處理、分析與儲存從遠端中央雲端轉移到更靠近資料來源的本地裝置或邊緣節點進行。核心優勢包含降低延遲、節省頻寬及提升資安隱私。
舉例:工廠產線攝影機與感測器持續產生影像和機台數據。若所有資料都先送到雲端再等待結果,無法滿足即時控制需求;透過邊緣運算,系統可先在現場辨識異常、觸發告警或調整設備,再把必要的資料送往雲端。
目錄
邊緣運算的定義
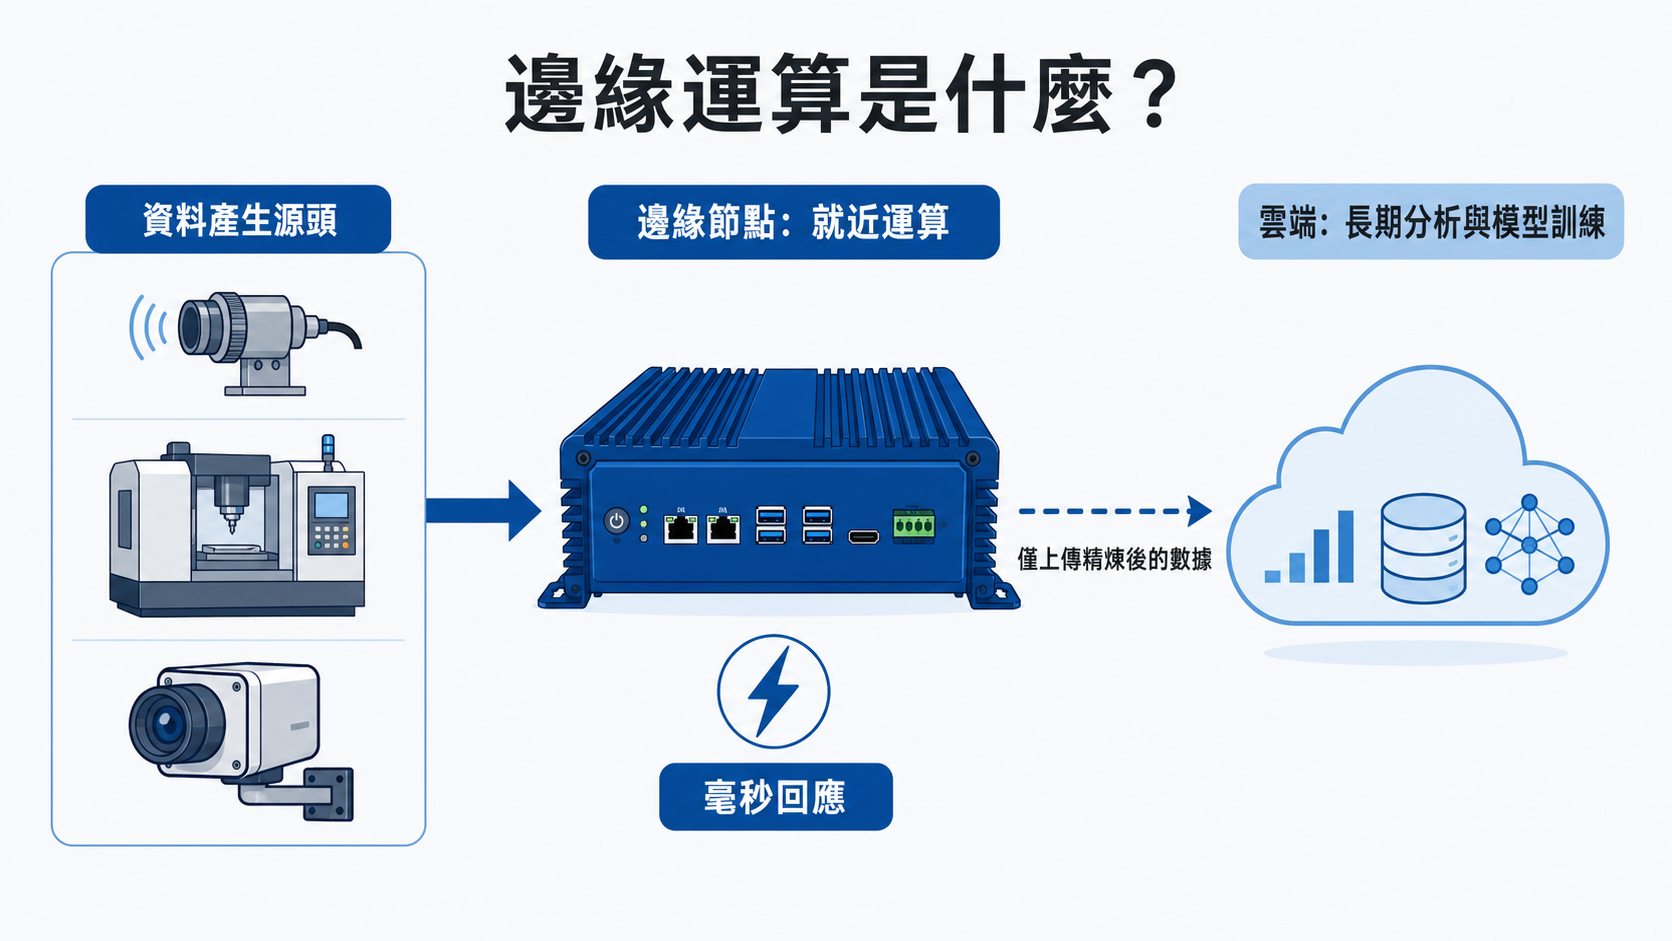
圖說:邊緣運算示意圖:運算從雲端移到資料產生源頭。
邊緣運算的核心概念是「讓運算靠近資料」,但並非將所有工作都移出雲端。過去常見的雲端架構,是把資料集中傳送到資料中心處理;邊緣架構則在資料源頭附近先完成即時判斷,再視需求與雲端同步。
在實際應用中,邊緣端可先執行協定轉換、資料清洗、事件過濾、規則判斷或 AI 推論,並即時觸發告警或設備控制,只將必要的異常紀錄、統計摘要或分析結果同步至雲端。
這樣不僅能降低資料往返造成的延遲與頻寬消耗,也能在網路不穩或中斷時,維持部分現場功能。
你可以把邊緣端想成身體的反射系統,負責快速回應;雲端則像大腦,適合彙整長期資料、訓練 AI 模型及進行跨廠區分析。兩者不是互相取代,而是依任務分工。
CNCF 將邊緣運算定義為一種分散式系統方法,透過將部分運算與儲存資源移至資料來源附近,讓資料能在本地端完成處理,再將必要結果送往中央資料中心。
一個好記的比喻:神經反應(邊緣)vs 大腦判斷(雲端)
想像你的手碰到滾燙的鍋子,手會在「想清楚」之前就縮回來——這是脊髓的反射動作,不需要經過大腦。它就像這套神經反射系統:在現場即時做出反應,處理急迫、規則明確的任務。
雲端則像大腦,負責需要大量記憶與深度思考的工作——彙整長期資料、訓練 AI 模型、做跨廠區的策略分析。
Fog Computing、Edge Computing、雲端運算:三者定位差異
介於雲端與邊緣之間,還有一個常被混用的名詞「霧運算」(Fog Computing)。三者的定位可以用下表快速釐清:
| 比較面向 | 雲端運算(Cloud) | 霧運算(Fog) | 邊緣(Edge) |
|---|---|---|---|
| 運算位置 | 集中式資料中心 | 區域網路層(如廠區機房) | 資料源頭(設備端、閘道器) |
| 延遲 | 較高(數十毫秒至秒級) | 中等 | 極低(毫秒級) |
| 適合任務 | 大數據分析、AI 模型訓練 | 區域資料彙整與過濾 | 即時推論、現場決策 |
| 網路依賴 | 高,斷線即中斷服務 | 中 | 低,可離線運作 |
| 典型場景 | ERP、跨廠區報表 | 園區級監控整合 | 產線品檢、設備監控 |
簡單來說,霧運算是雲與邊緣之間的「中繼層」,而邊緣是離資料最近的第一線。實務上,許多企業的架構會同時包含這三層。
關於霧運算節點、分散式部署及其與雲端架構的關係,可進一步參考 NIST 發布的《Fog Computing Conceptual Model》。
為什麼邊緣運算變得重要?
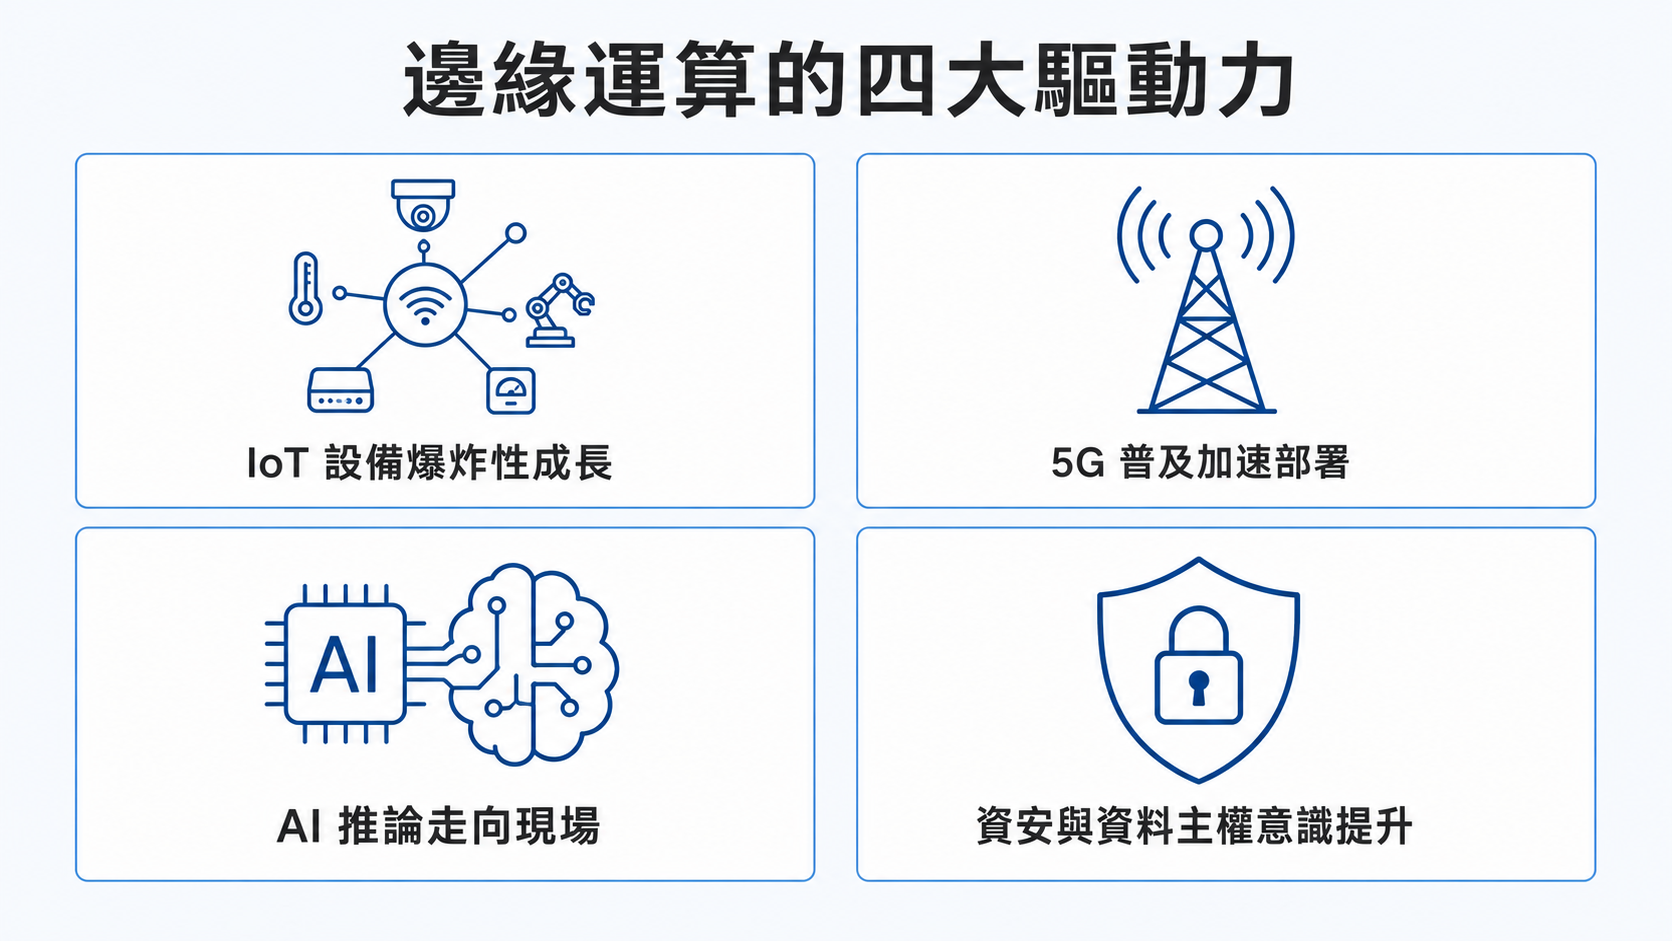
圖說:推動邊緣運算普及的四大驅動力。
IoT 與工業設備持續產生大量資料
CNC 機台、PLC、感測器與攝影機會持續產生資料。若將所有原始數據長期上傳,不僅占用頻寬,也會增加儲存與處理成本。邊緣節點可先清洗、彙整或篩選資料,只上傳異常事件與必要摘要。
関連記事:産業用IoT(IIoT)の動向
AI 推論需要在現場執行
AI 模型通常可在雲端完成訓練,但品質檢測、設備異常辨識或安全監控等推論任務,常需要部署到實際場域。邊緣 AI(Edge AI)可減少資料傳輸等待時間,讓系統更快產生判斷結果。
企業對資安與資料主權意識提升
製程參數、配方、影像與個資可能不適合直接送出場域。
將原始資料留在地端處理,有助於降低資料外傳與法規遵循風險;不過,企業仍需搭配身分驗證、權限控管、加密、更新與事件監控等完整資安措施。
5G 專網可提升移動設備與多節點通訊能力,但邊緣運算並不以 5G 為必要條件,也可透過有線網路、Wi-Fi 或 4G 部署。
在電信與行動網路情境中,ETSI 將此類架構稱為多接取邊緣運算(Multi-access Edge Computing,MEC),讓應用服務可以部署在更接近網路使用者的位置。
邊緣運算的五大優勢
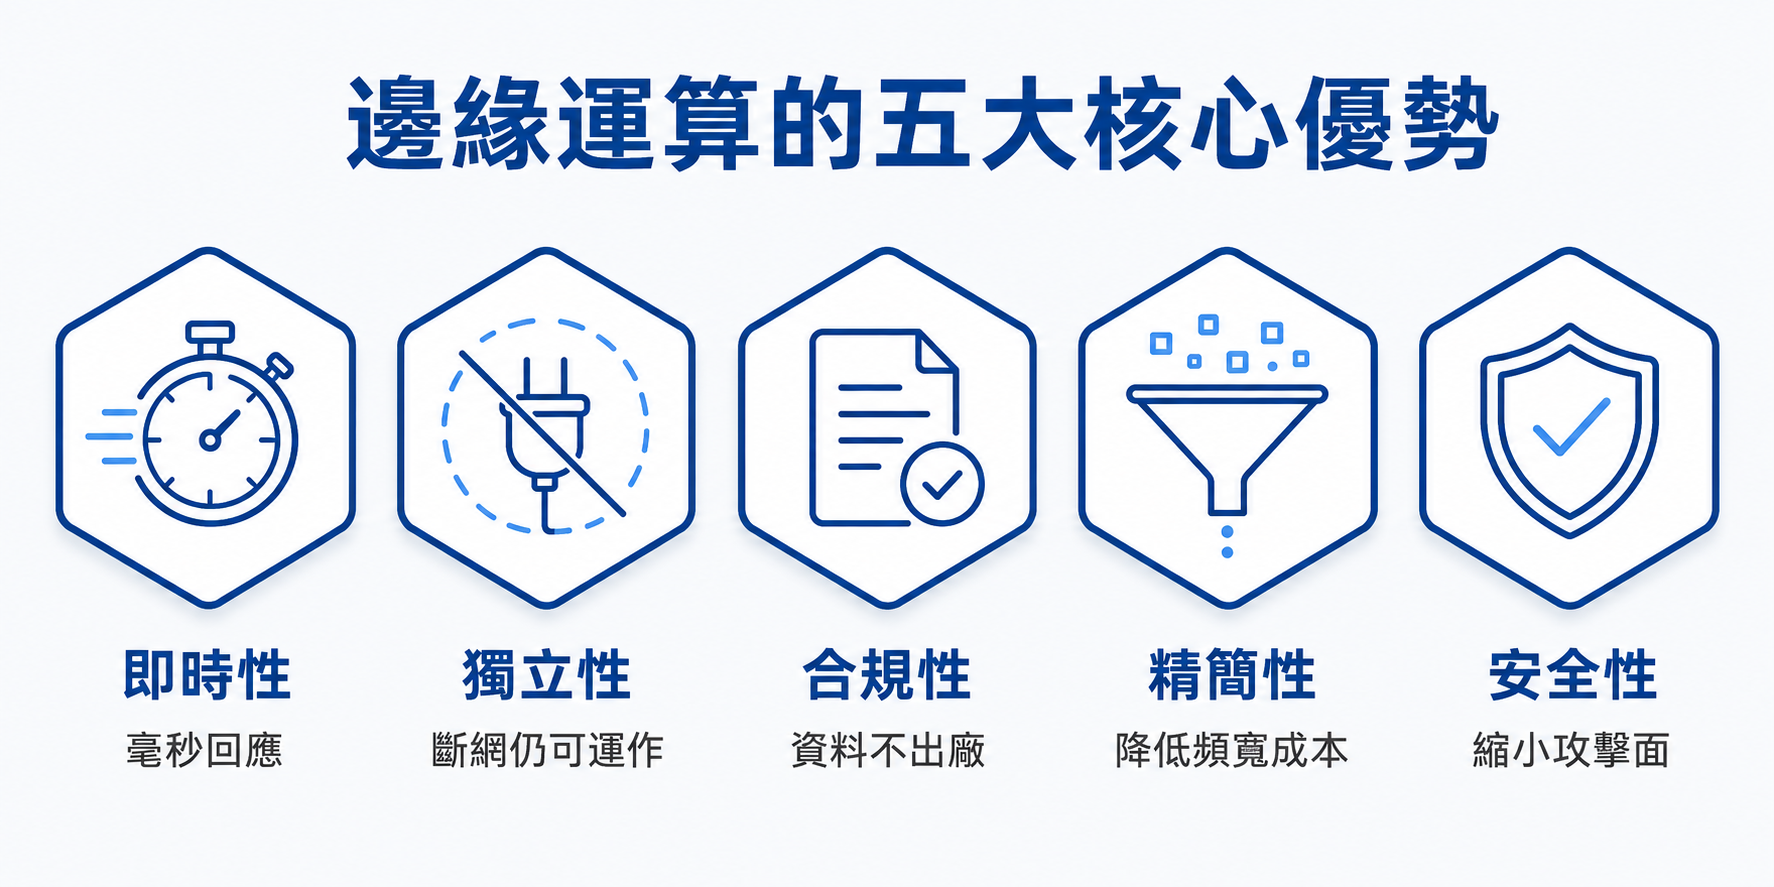
圖說:邊緣運算五大核心優勢一覽。
即時性:本地運算,毫秒回應
資料不必往返雲端,省下網路傳輸的來回時間,回應速度可從秒級縮短到毫秒級。
對於產線瑕疵剔除、機械手臂協作、自駕車煞車判斷這類「慢一步就出事」的應用,即時性是不可妥協的底線。
獨立性:無網路仍可運作
邊緣節點具備獨立運算能力,即使對外網路中斷,現場的監控、控制與資料收集仍能持續運作,待網路恢復後再同步回雲端。
對於位處偏遠的能源站點、訊號不穩的移動場域,這種「斷線不斷線」的韌性至關重要。
合規性:資料不出廠,符合個資法規
將影像、聲音等涉及個資的原始資料,在邊緣端完成辨識與去識別化,只將統計結果或事件訊號上傳,原始資料不出場域。
這讓企業在導入 AI 應用時,也能符合個資法與產業資安規範的要求。
精簡性:資料先過濾再上雲,降低頻寬
工業現場產生的原始數據中,往往九成以上是「一切正常」的重複訊號。
邊緣節點可在源頭先完成資料清洗,只把有價值的異常事件與統計摘要送上雲端,頻寬用量與雲端儲存成本都能大幅下降。
安全性:減少傳輸路徑,降低攻擊面
資料傳輸的路徑愈長、經手的節點愈多,被攔截或竄改的風險就愈高。
就近運算縮短了資料的旅行距離,配合 TLS 加密通訊與 IEC 62443 等工控資安標準,能有效縮小整體系統的攻擊面。
邊緣運算架構怎麼運作?
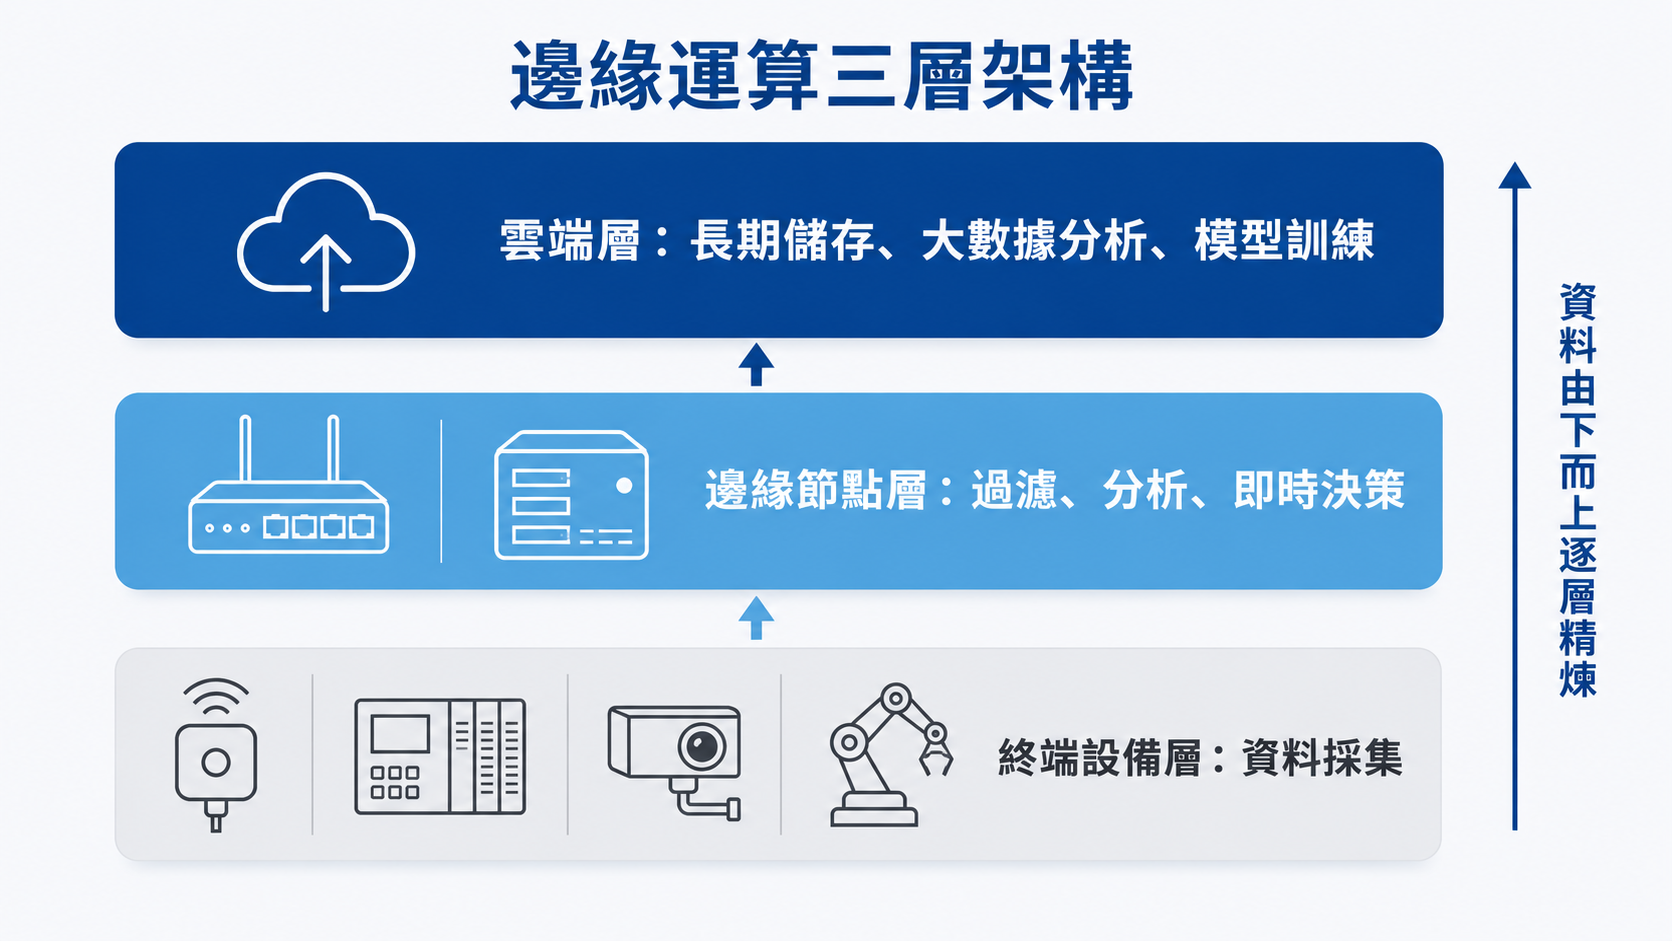
圖說:終端設備、邊緣節點到雲端的三層架構。
典型的邊緣架構由三層組成:
1.終端設備層:感測器、PLC、攝影機等資料產生源
2.邊緣節點層:工業閘道器、邊緣伺服器或工業電腦(IPC),負責就近運算
3.雲端層:負責長期儲存、大數據分析與模型訓練。
資料通常由下而上逐層整理:終端設備產生原始資料,邊緣節點先判斷與篩選,雲端再處理需要長期累積或大規模運算的工作。
以設備振動監測為例,感測器先採集訊號,邊緣節點計算特徵並判斷是否異常;只有告警、趨勢或必要片段需要上傳,雲端再用於跨設備比較與模型優化。
邊緣節點負責哪些工作?
1.協定與資料整合:串接 Modbus、OPC UA、MQTT 等協定,轉換成一致的資料格式。
2.即時分析:執行規則引擎、資料前處理或 AI 推論。
3.現場控制:依判斷結果觸發告警、派送事件或調整
設備。
4.應用部署與管理:透過容器化方式更新應用,並集中管理多個節點的版本與健康狀態。
在工業場域中,邊緣節點也可搭配 OTデータETL,將不同設備產生的資料進行擷取、轉換、清洗與格式標準化,建立可供後續分析與 AI 模型使用的資料基礎。
関連記事: AI転換の開始。データは準備はできていますか?
邊緣運算的主要應用場景
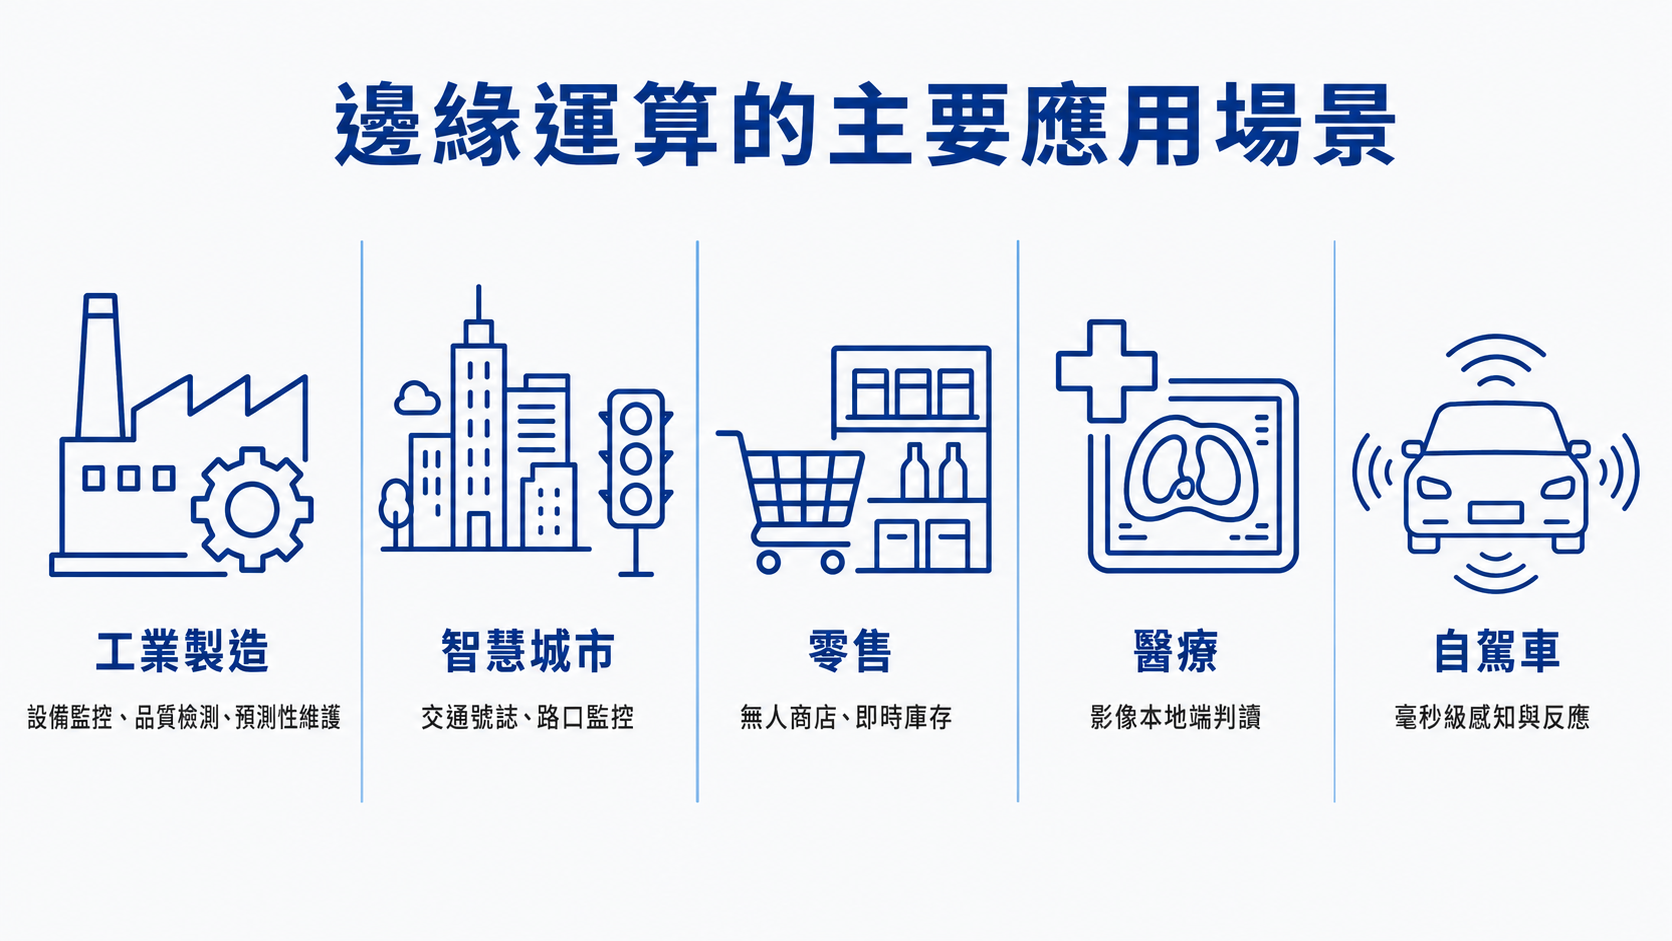
圖說:邊緣運算五大產業應用場景。
工業製造
邊緣運算可用於設備狀態監控、AOI 品質檢測與預測性維護。例如,節點持續分析振動、溫度與電流,在異常時即時告警;影像模型則可在產線旁判定良品與不良品。
若搭配工單、批次與製程參數,還能協助品質或維護人員縮小問題範圍。
智慧城市與交通
路口設備可先在本地分析車流、行人與事件,再回傳統計資料或告警訊號,降低大量影像集中傳輸造成的負擔。
交通號誌也可依現場狀況快速調整,不必等待所有影像送回中心機房後再處理。
零售與物流
門市可即時分析貨架庫存、顧客動線或取物事件,缺貨時快速通知補貨;倉儲則可用於設備監控、影像辨識與 AGV 任務協調。
各據點可先在地端處理,再把必要的營運摘要回傳總部。
醫療與移動設備
院內邊緣伺服器可處理部分醫療影像或床邊監測資料,在兼顧時效的同時降低敏感原始資料外傳。
自駕車與移動機器人則主要在車載或機載平台完成感知、判斷與控制,以避免煞車、避障等關鍵反應依賴遠端連線。
自駕車:毫秒級感知與反應
自駕車是「移動的邊緣節點」的極致案例。車輛必須在數十毫秒內完成感知、判斷與控制,因此感測器融合與 AI 推論全數在車載運算平台上完成,雲端只負責車隊管理與模型的持續優化。
邊緣運算 vs 雲端運算:如何分工?
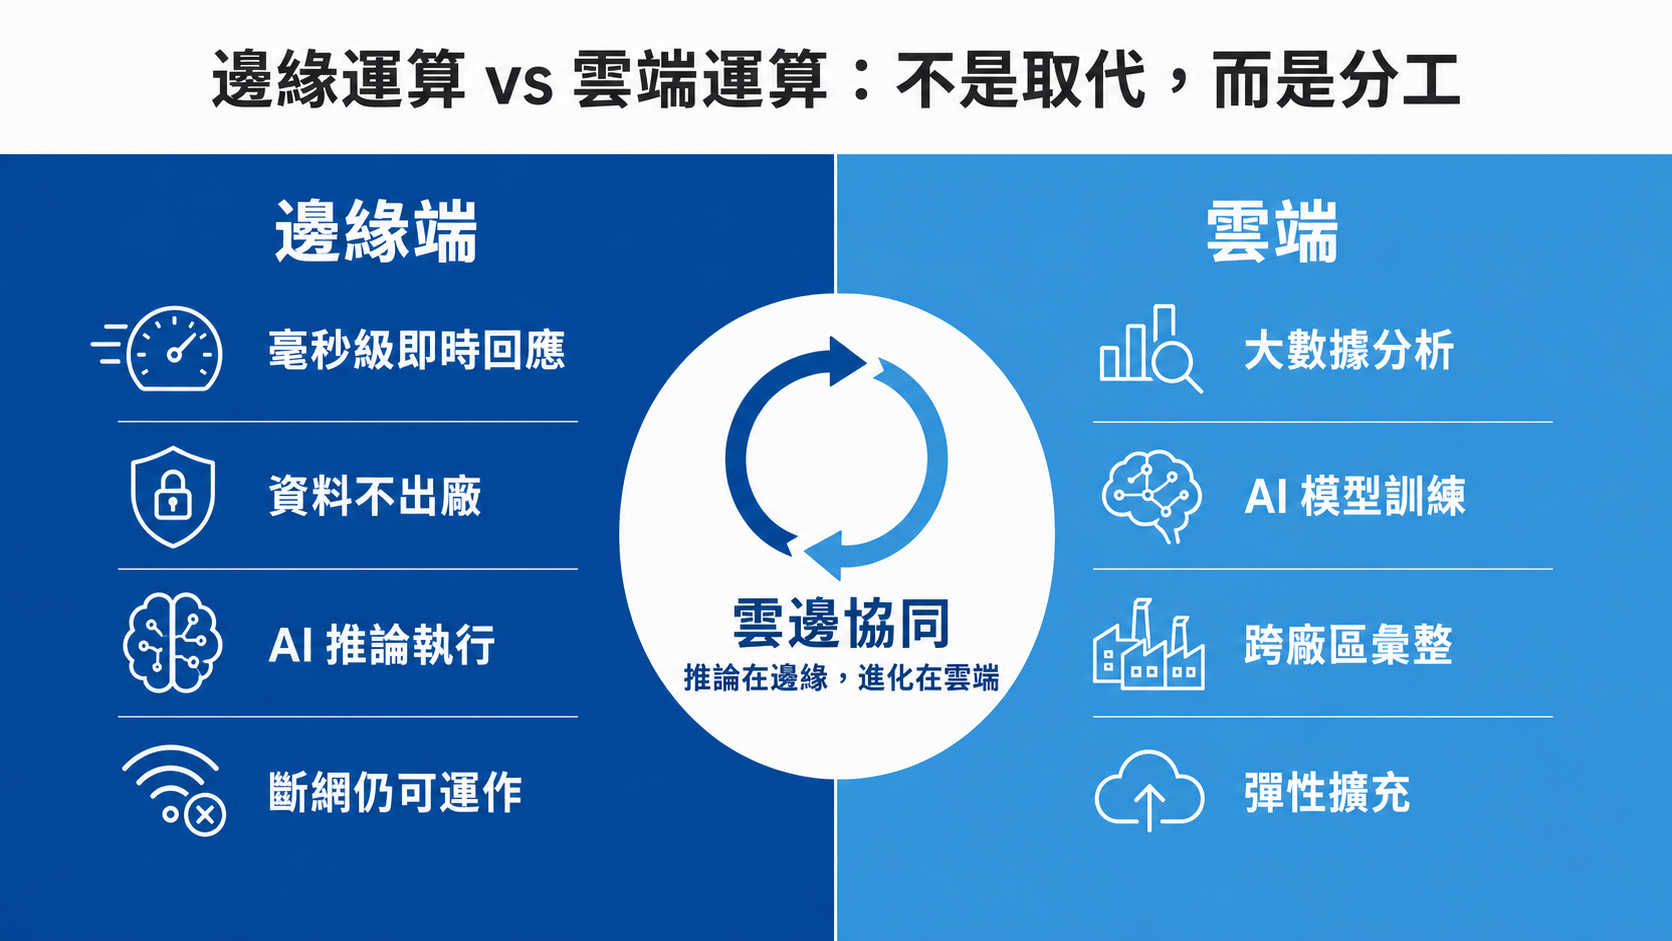
圖說:雲邊協同架構:地端推論、雲端優化。
什麼情況選邊緣?什麼情況留在雲端?
| 判斷維度 | 適合邊緣端 | 適合雲端 |
|---|---|---|
| 延遲要求 | 毫秒級即時回應 | 可容忍秒級以上 |
| 資料敏感度 | 不可出廠、涉及個資 | 可去識別化後集中分析 |
| 網路條件 | 不穩定、頻寬有限 | 穩定且充足 |
| 運算類型 | AI 推論、規則判斷 | AI 模型訓練、大數據分析 |
| 資料生命週期 | 即時消費、用完即棄 | 長期儲存、歷史回溯 |
| 規模彈性 | 節點數固定、就地部署 | 需求波動大、彈性擴充 |
混合架構趨勢:地端即時推論 + 雲端長期優化
常見做法是「雲邊協同」:邊緣端執行即時推論與現場決策,雲端彙整資料、重新訓練模型,再將新版應用或模型部署至各節點。
企業不必在邊緣與雲端之間二選一,而應依延遲、資料敏感度、成本及管理需求分配工作。
導入邊緣運算的限制與挑戰
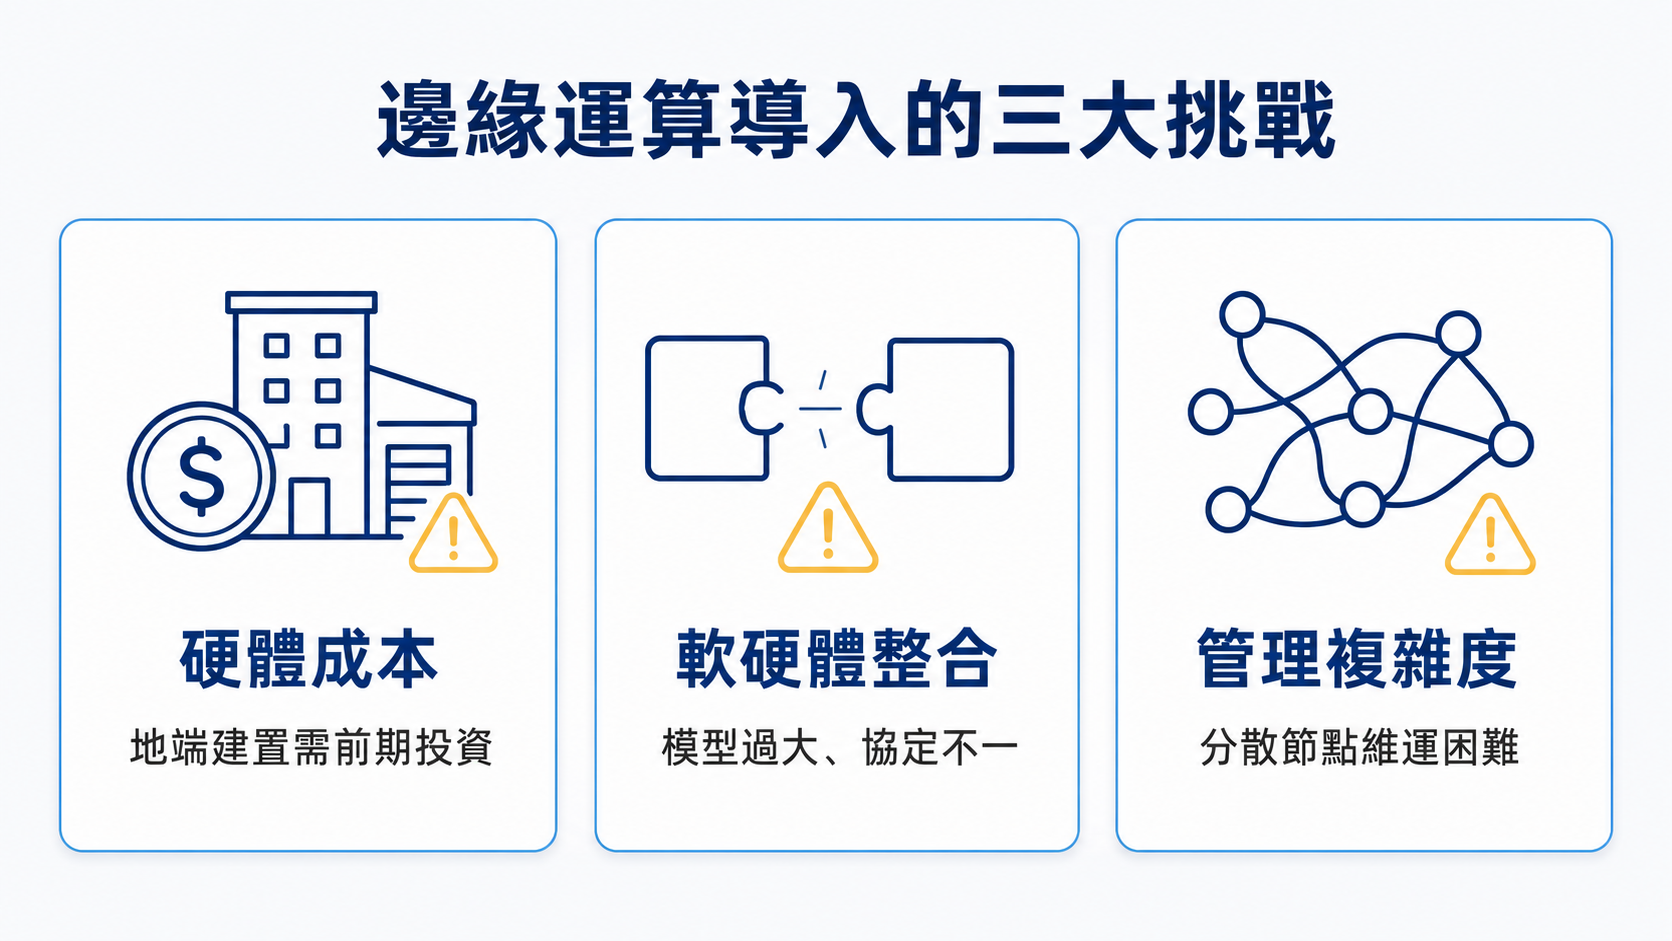
圖說:企業導入邊緣運算的三大挑戰。
硬體成本:地端建置比雲端貴
雲端的魅力在於「用多少付多少」,而邊緣建置需要在每個場域預先投資硬體。若場域數量多、單點價值低,前期投資回收(ROI)的計算就必須格外謹慎。
軟硬體整合:模型不夠小、記憶體與頻寬有限
邊緣設備的算力、記憶體與功耗都有嚴格限制,動輒數十 GB 的大型 AI 模型無法直接塞進邊緣裝置,需要透過模型壓縮、量化或蒸餾等技術瘦身。
此外,不同品牌設備的協定與資料格式各異,缺乏統一的整合平台時,系統整合成本會迅速失控。
管理複雜度:分散節點的維運挑戰
當邊緣節點從 5 個成長到 500 個,逐台登入更新軟體、排查故障將成為維運惡夢。
集中式的節點管理、遠端部署、版本控管與健康監控能力,是企業規模化導入前必須解決的課題——這也是「邊緣協作管理平台」這類軟體崛起的原因。
邊緣運算導入選型指南:五個評估重點
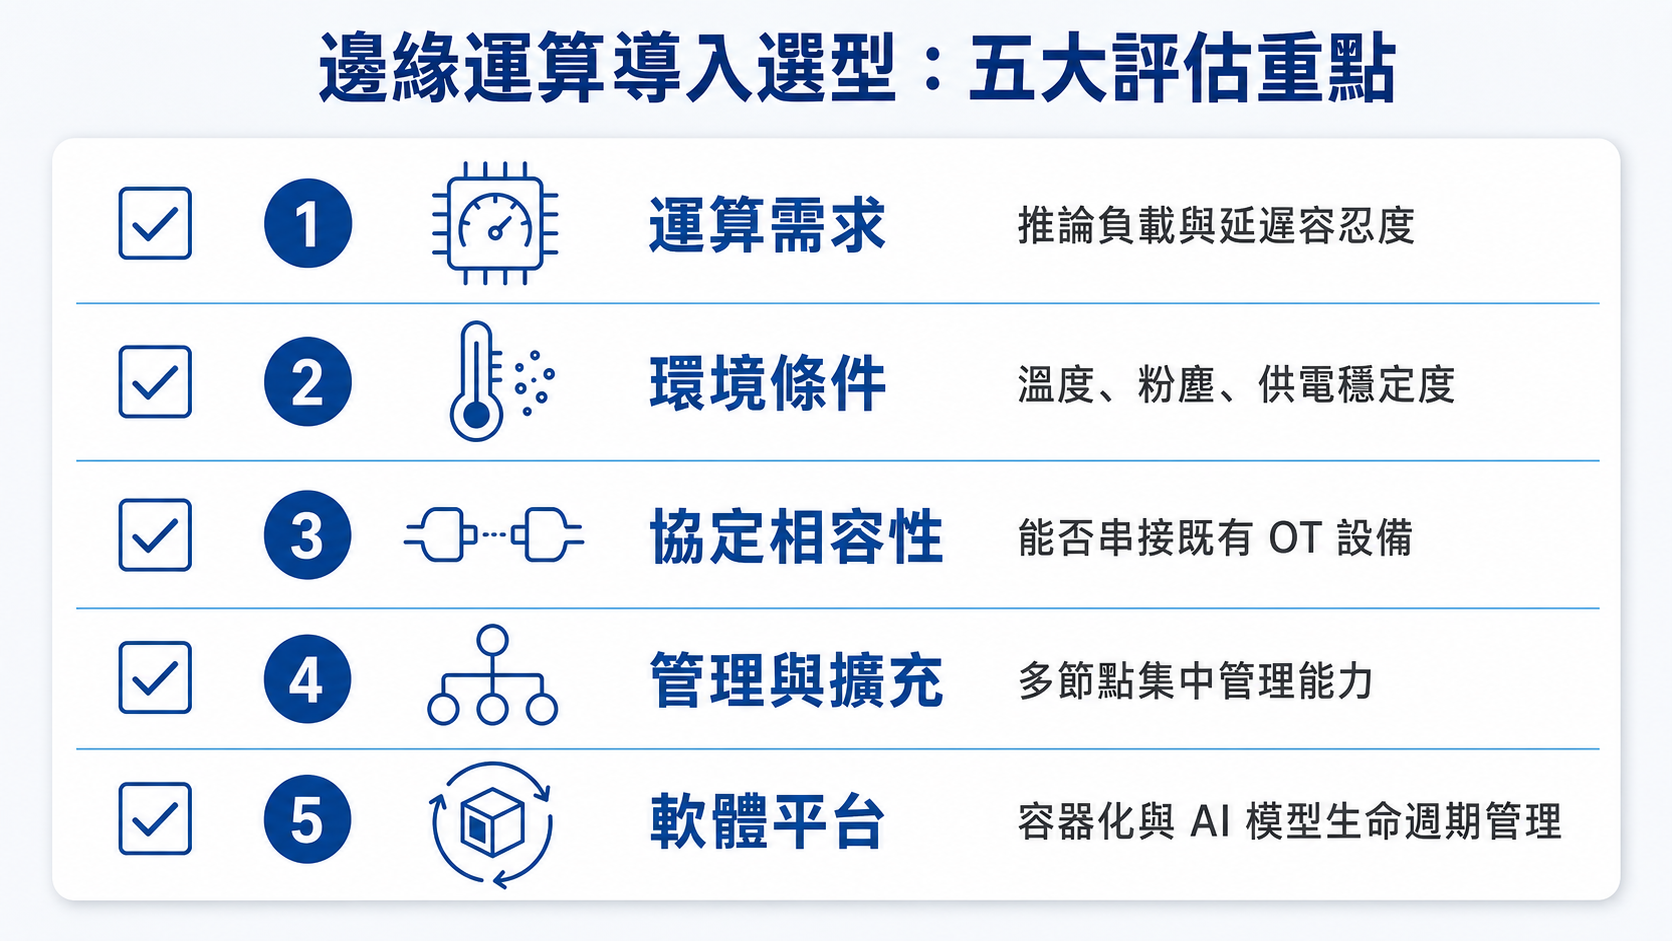
圖說:邊緣運算選型五大評估重點檢核表。
準備導入的企業,建議依下表逐項評估:
| 評估重點 | 關鍵問題 | 常見陷阱 |
|---|---|---|
| 運算需求 | 推論負載多大?延遲容忍度多少毫秒? | 用過高規格硬體處理簡單任務,成本失衡 |
| 環境條件 | 廠區溫度、粉塵、震動、供電是否穩定? | 用商用設備硬撐工業環境,故障率飆升 |
| 協定相容性 | 能否串接既有 OT 設備與工業協定? | 忽略老舊設備,導致資料孤島依然存在 |
| 管理與擴充 | 是否支援多節點集中管理與遠端部署? | 試點成功後才發現無法規模化 |
| 軟體平台 | 是否支援容器化與 AI 模型生命週期管理? | 只買硬體不評估軟體,整合成本爆表 |
評估重點
最容易被低估的是「協定相容性」與「軟體平台」。
台灣製造業現場普遍存在跨品牌、跨年代的設備組合,若選型時只比較硬體規格,忽略了 OT 數據整合與模型管理能力,往往在概念驗證(PoC)之後就卡關,難以走向全廠部署。
邊緣運算市場規模與未來趨勢
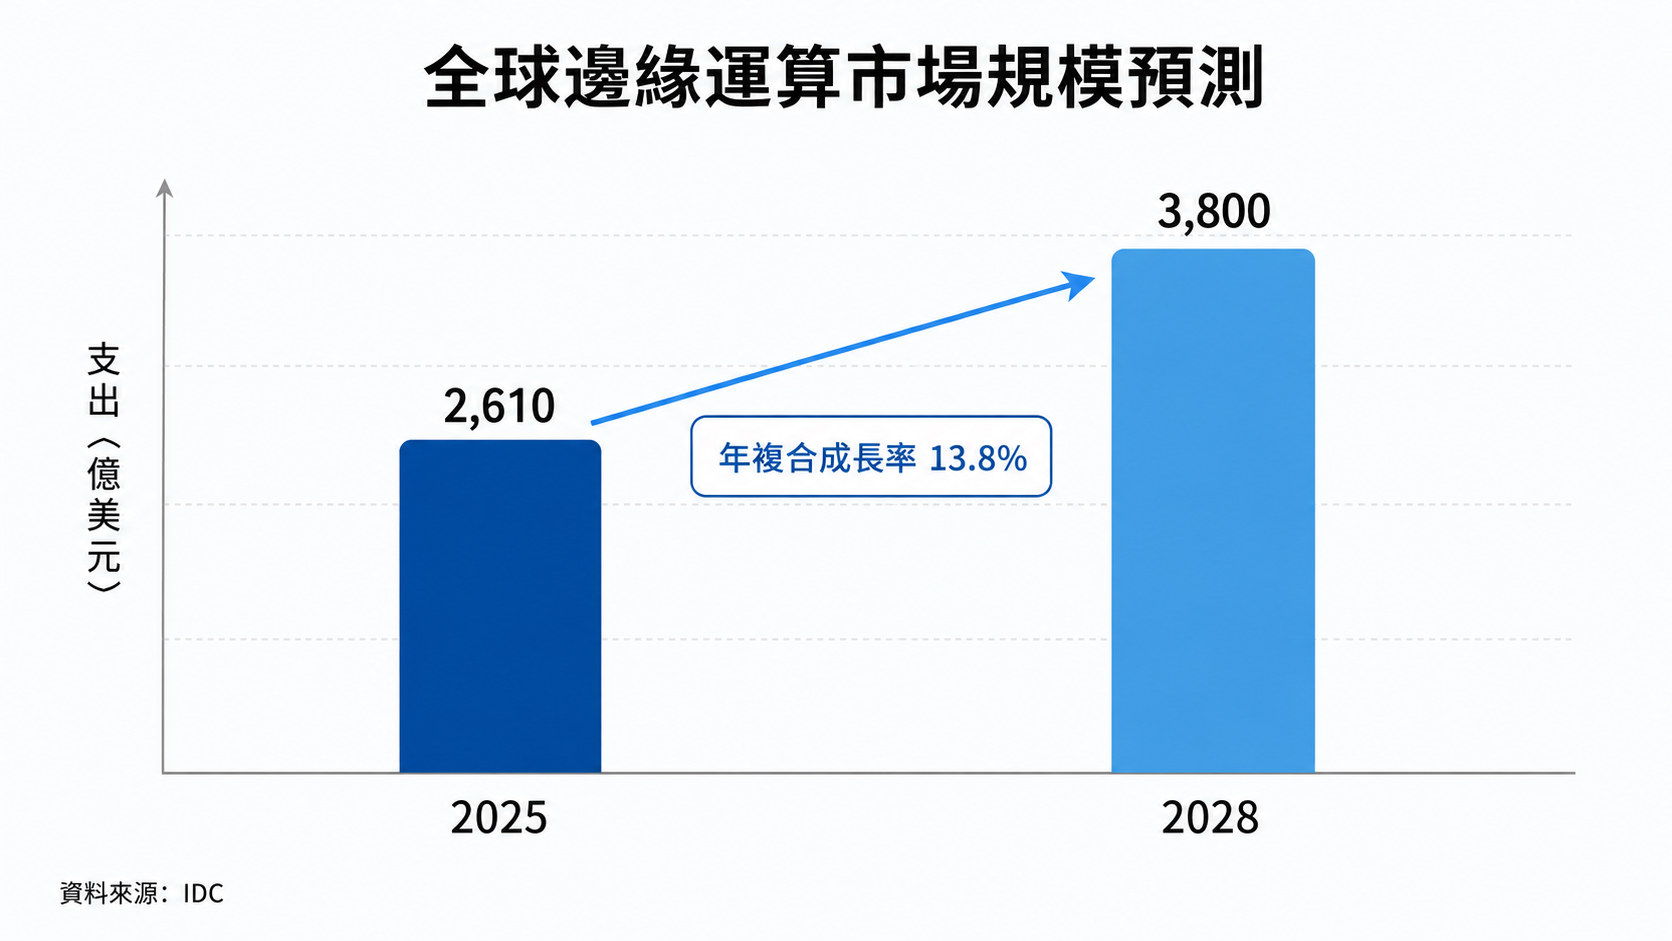
圖說:全球邊緣運算市場規模預測(資料來源:IDC)。
IDC:2025 年全球邊緣運算支出近 2,610 億美元
根據 IDC 官方支出指南最新預測,2025 年全球相關解決方案支出接近 2,610 億美元,並將以 13.8% 的年複合成長率持續成長,2028 年可望達到 3,800 億美元;其中製造與資源產業約占整體支出的四分之一,是最主要的投資族群之一。
AI Agent + 邊緣運算:下一波殺手級應用
隨著大型語言模型與 AI Agent 技術成熟,邊緣端的角色正從「執行單一模型推論」進化為「承載智慧代理人」。
AI Agent 可透過 MCP(Model Context Protocol)等標準介面存取現場的 OT 數據,自動比對維修 SOP、生成工單建議,讓邊緣端不只會「偵測」,更會「思考下一步」。
6G 與邊緣 AI 原生化趨勢
下一代通訊標準 6G 在設計之初,就將 AI 與邊緣智慧納入原生架構,未來網路本身就是一台分散式的智慧電腦。
對企業而言,這意味著邊緣運算不再是選配,而是數位基礎建設的標配,企業越早建立邊緣資料治理能力,就能越快享受技術紅利。
從資料蒐集到 AI 決策:雲界數位提供可落地的邊緣運算解決方案
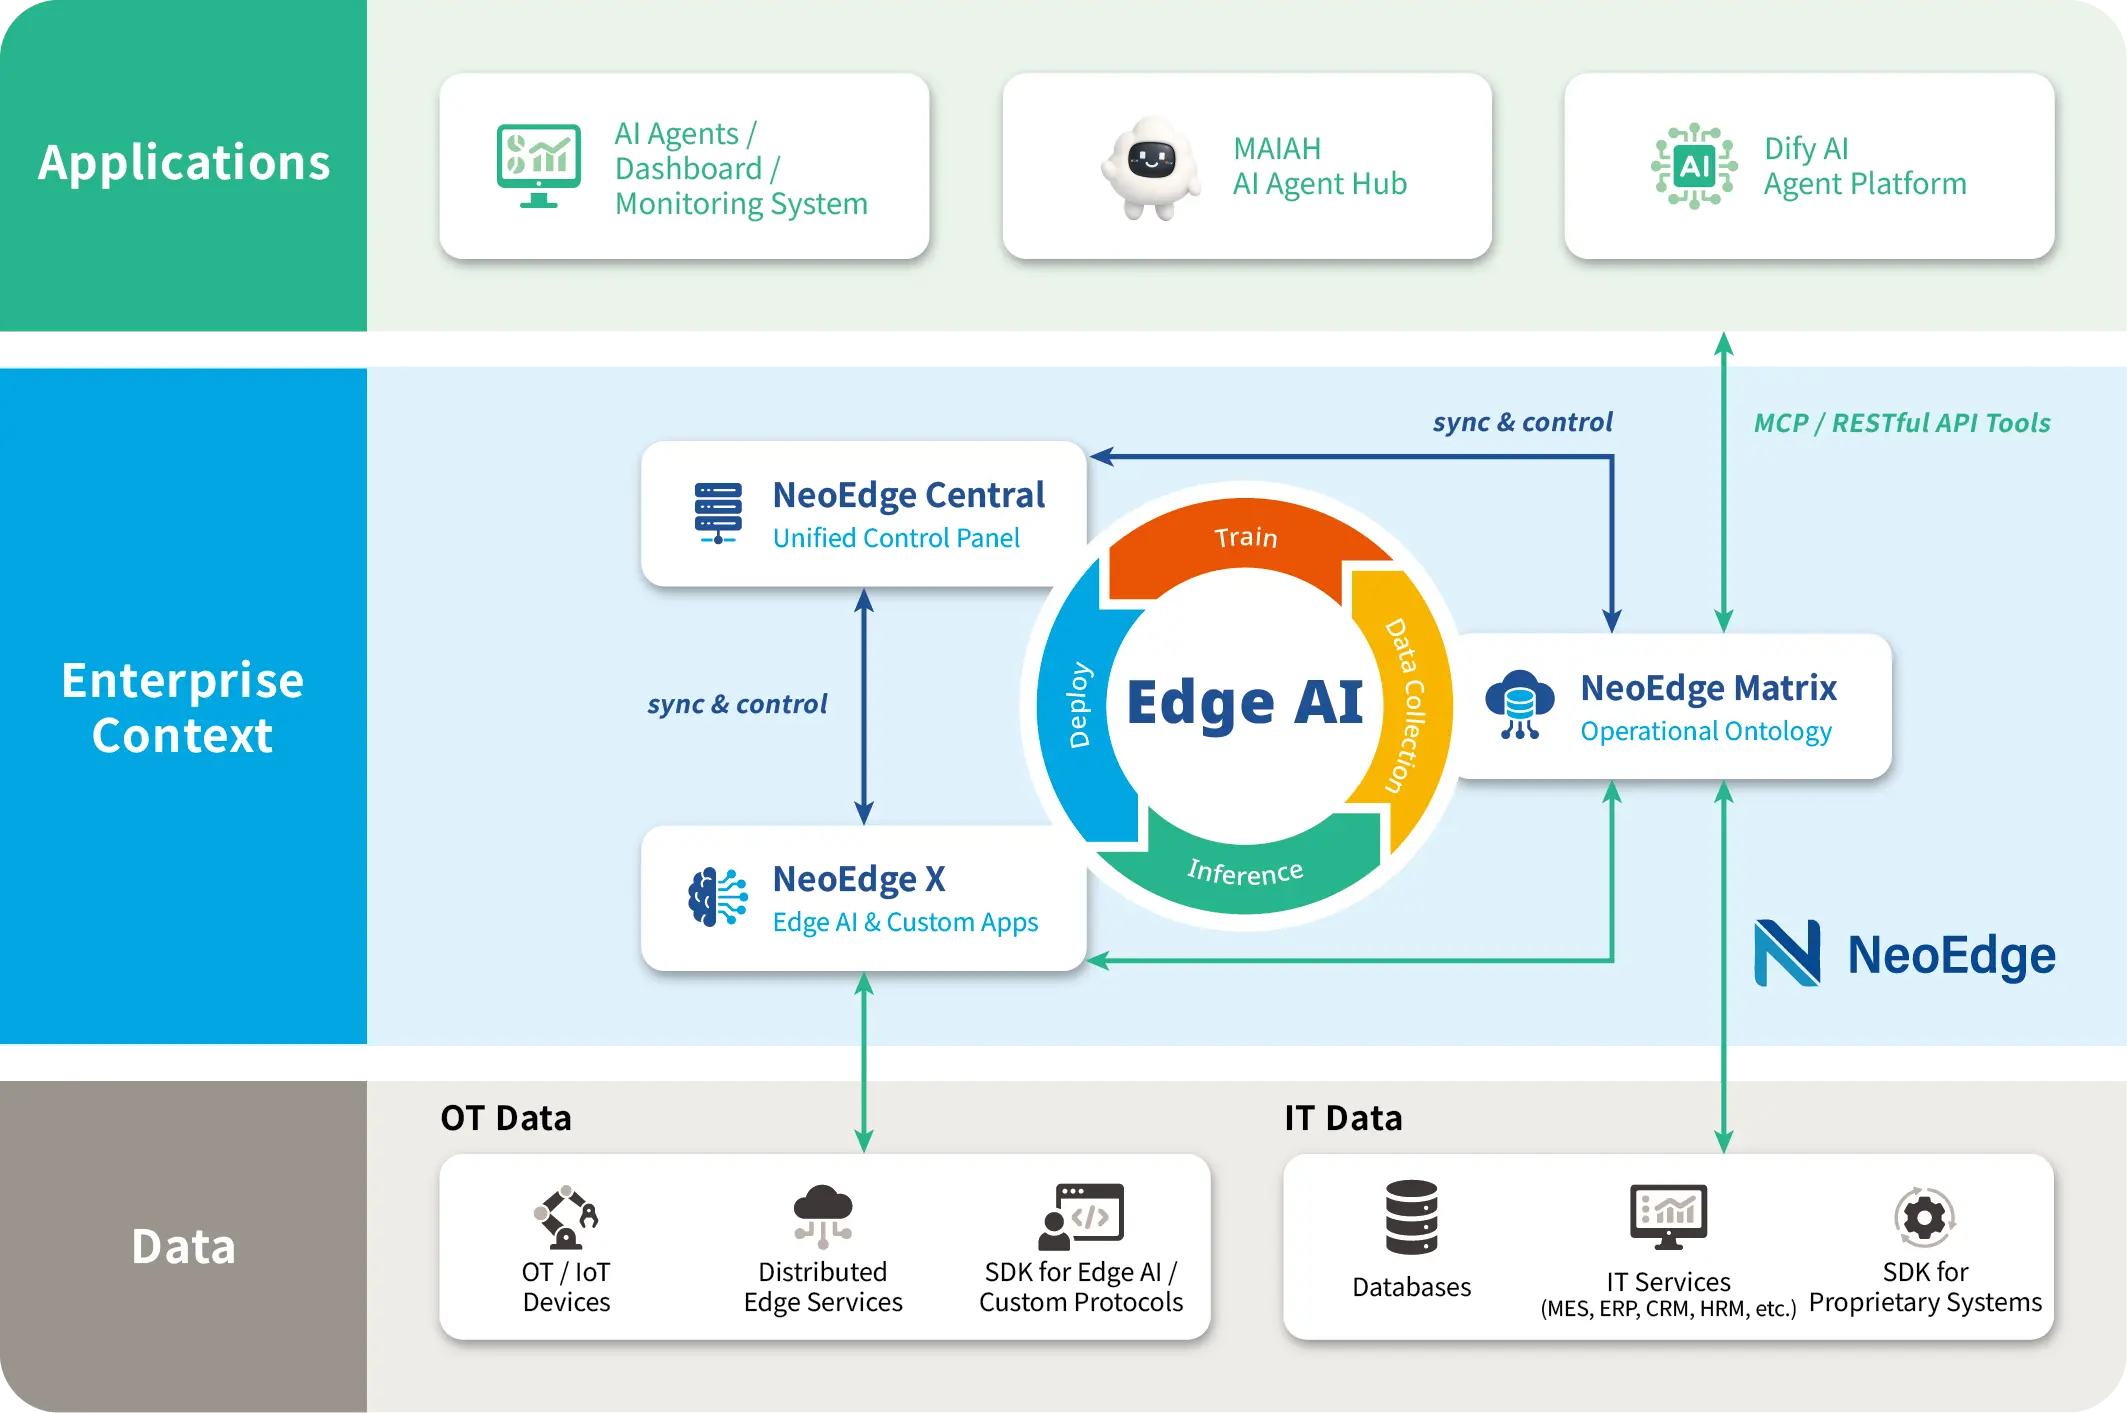
圖說:NeoEdge 數據治理與工業 AI 協作平台架構圖:NeoEdge X 串接現場設備與工業協定,NeoEdge Central 整合 AI 應用與管理系統。
雲界デジタル eCloudEdge・イノベーションが開発した NeoEdge データガバナンスと産業用AI連携プラットフォームそれは、 OT データと AI アプリケーションを連携させるために生まれたものです。我々は分散した産業協定や複雑な設備、複雑な AI モデルを単一のプラットフォームに統合することに注力しており、これらは単 AIoT なるプレゼンテーション上の概念ではなく、実際に工場内で実行され、ROIを生み出すソリューションとなるのです。
もし AIoT 導入を計画中であり、AIの価値をデータ OT から引き出すことを望んでいるのであれば、お問い合わせはこちらAIoT 導入ニーズに関するインタビューを実施し、データ収集からAIによる意思決定までのプロセスを支援する方法 NeoEdge について理解を深めます。
常見問題 FAQ
Q1:邊緣運算是什麼?
邊緣運算是把資料處理從雲端移到資料產生源頭附近執行的運算架構。
以工廠為例,產線攝影機拍到的影像直接在旁邊的工業電腦上完成瑕疵判定,不必上傳雲端,判定結果毫秒內就能觸發剔除機構,這就是典型的邊緣應用。
Q2:邊緣運算和雲端運算有什麼不同?會取代雲端嗎?
兩者的差異在於運算位置:邊緣在資料源頭就近處理,強項是即時與資安;雲端運算集中處理,強項是算力與彈性。
它不會取代雲端,主流架構是雲邊協同——邊緣負責即時推論,雲端負責模型訓練與長期分析,兩者分工互補。
Q3:邊緣運算的缺點有哪些?
1.前期硬體建置成本較高,不像雲端可以隨用隨付
2.邊緣設備的算力與記憶體有限,大型 AI 模型需要壓縮才能部署
3.節點分散造成維運複雜,需要具備集中管理與遠端部署能力的平台工具,否則規模化後管理成本會快速上升。
Q4:邊緣運算一定要有 5G 才能運作嗎?
不一定。
它的核心是「就近處理」,透過有線網路、Wi-Fi 或 4G 都能運作,甚至在完全離線的環境也能獨立執行。5G 的角色則是加速器,其低延遲與大連結特性讓移動式、跨節點協作的邊緣應用(如 AGV 調度)更容易實現,但並非必要條件。
Q5:工廠想導入邊緣運算,應該從哪裡開始?
建議從「單一高價值場景」切入,例如關鍵設備的預測性維護或產線品檢。第一步是盤點現場設備的通訊協定與資料可取得性,第二步選擇能整合既有設備、支援集中管理的邊緣平台進行概念驗證,驗證 ROI 後再逐步擴大到全廠部署,避免一開始就追求大而全的架構。